Serveurs GPU
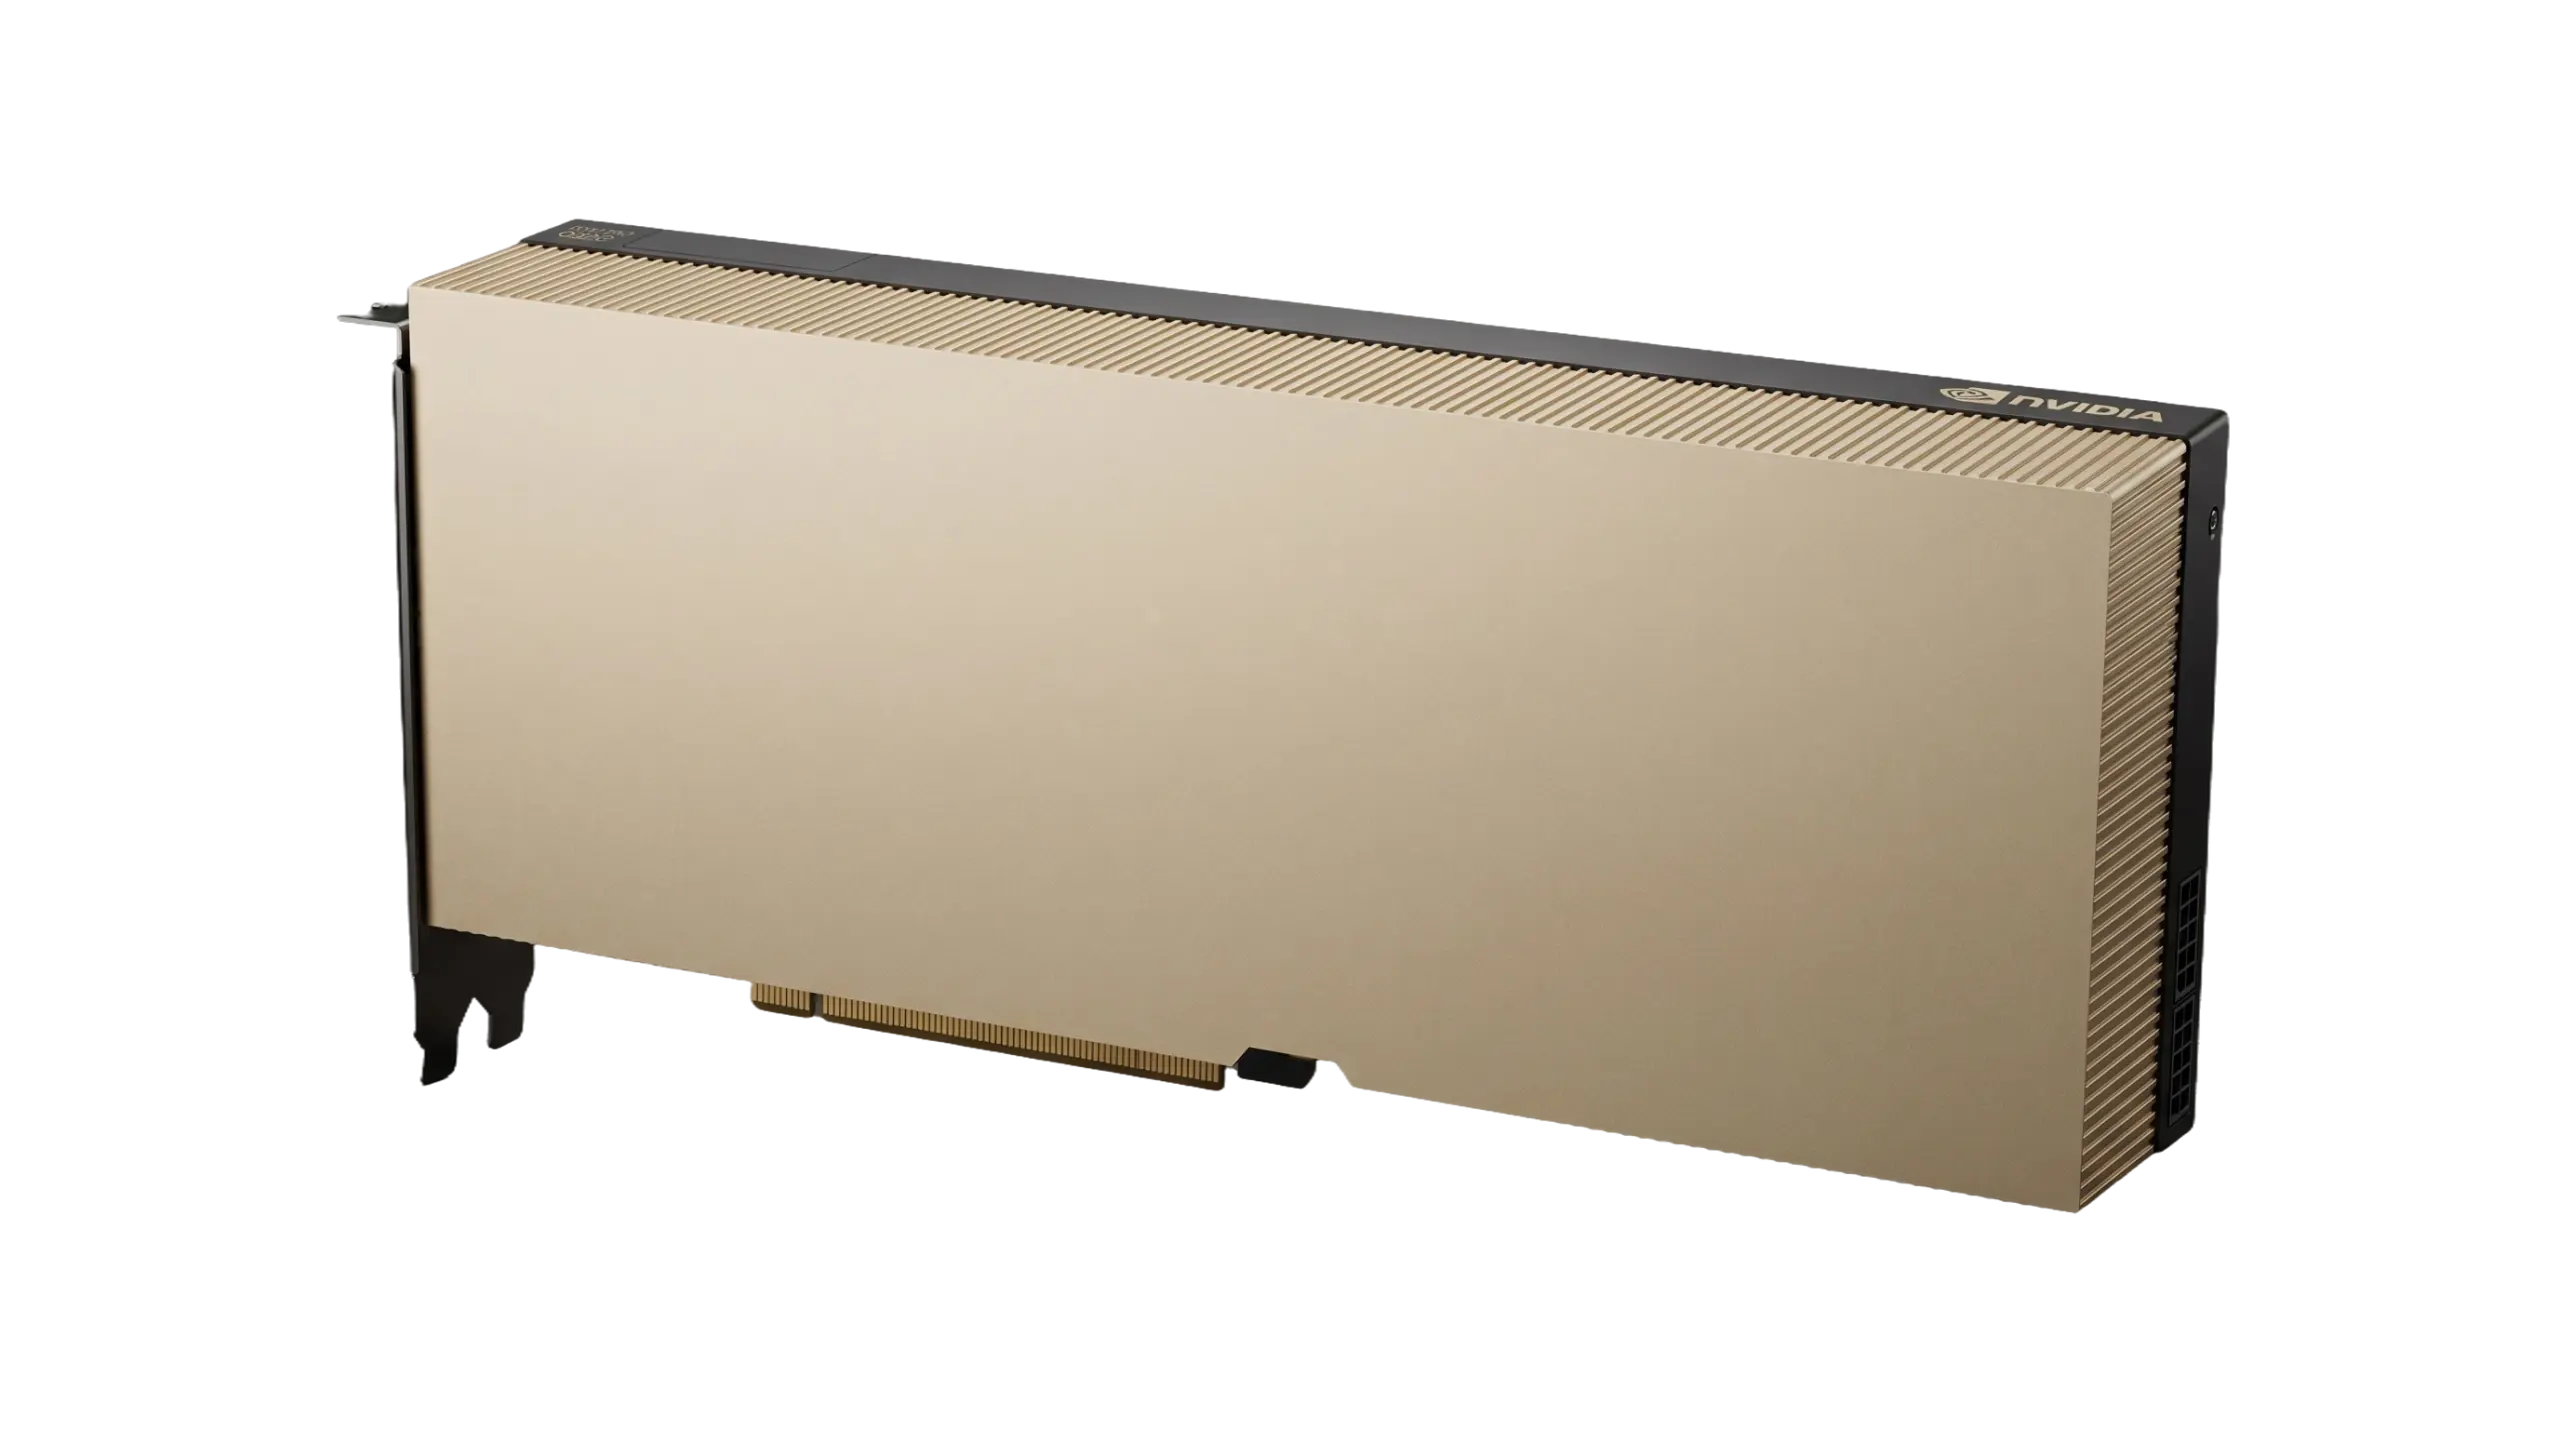
NVIDIA RTX Pro 6000 Blackwell : le GPU idéal pour l’IA générative et le calcul intensif
96 Go de VRAM, mémoire ECC et partitionnement MIG : le meilleur coût par Go pour exécuter des LLM en local.
La NVIDIA RTX Pro 6000 Blackwell marque une rupture majeure dans le monde des GPU professionnels. Grâce à ses 96 Go de mémoire, elle devient l’un des meilleurs rapports performance / prix pour exécuter localement des modèles d’IA générative (LLM).
Alors que les modèles compacts nécessitent entre 50 et 90 Go de VRAM, les générations précédentes plafonnaient à 32 Go (hors cartes datacenter comme la H100). Résultat : difficile d’héberger des modèles performants en interne sans exploser les coûts.
Comparatif des coûts par Go de VRAM
| GPU | Capacité VRAM | Prix estimé | Coût par Go | Limites |
|---|---|---|---|---|
| NVIDIA H100 80 Go | 80 Go | ~38 000 € | 600 €/Go | Réservée au datacenter |
| NVIDIA RTX 5090 32 Go | 32 Go | ~2 500 € | 150 €/Go | Capacité VRAM limitée |
| NVIDIA RTX Pro 6000 Blackwell 96 Go | 96 Go | – | ≈110 €/Go | Meilleur compromis pro |
Avec la RTX Pro 6000 Blackwell, un serveur peut atteindre 576 Go de VRAM pour un coût maîtrisé, tout en conservant une consommation similaire aux H100 ou 5090.
Une carte graphique polyvalente pour IA, rendu 3D, data science et applications professionnelles
La RTX Pro 6000 repose sur l’architecture NVIDIA Blackwell, conçue pour répondre à la montée en puissance des modèles IA.
MIG (Multi Instance GPU) : jusqu’à 24 GPU virtuels
Le mode MIG permet de créer :
- jusqu’à 4 instances de 24 Go par carte, soit
- jusqu’à 24 instances GPU par serveur.
👉 Parfait pour partager un serveur GPU entre plusieurs collaborateurs ou orchestrer des workloads parallèles.
Lien externe recommandé : https://www.nvidia.com/fr-fr/technologies/multi-instance-gpu/
Mémoire ECC : fiabilité professionnelle
La RTX Pro 6000 adopte une mémoire ECC, indispensable lorsque la donnée doit être fiable :
- calcul scientifique
- machine learning
- phases d’entraînement IA
C’est un avantage inexistant sur les gammes grand public comme les RTX 5090.
Mémoire GDDR7 : bande passante jusqu’à 1,6 To/s
Bien que différente de la HBM des GPU datacenter, la GDDR7 offre :
- une bande passante de 1,6 To/s
- des performances comparables à de la HBM2
Idéal pour des contextes multi-usages.
PCIe Gen 5 : la fin du NVLink, sans perte réelle
Le PCIe Gen 5 atteint une bande passante de 64 Go/s, proche du NVLink disponible sur les anciennes Pro A6000.
Avantage : meilleure compatibilité logicielle, moins de contraintes d’interconnexion.
Sorties vidéo & capacités graphiques
Même pensée pour l’IA, la carte propose :
- 4 sorties vidéo
- 4 flux 4K 165 Hz ou 2 flux 8K 100 Hz
- Ray Tracing + DLSS
→ Un vrai GPU hybride : IA et rendu graphique.
Consommation ajustable : 300 W, 450 W ou 600 W
Ce qui permet :
- d’adapter la carte à l’alimentation disponible
- de réduire la chaleur
- d’améliorer la stabilité en cluster
Pourquoi la RTX Pro 6000 Blackwell est idéale pour les entreprises (10 à 100 utilisateurs)
La différence avec un GPU datacenter :
| Caractéristique | RTX Pro 6000 Blackwell | H100 |
|---|---|---|
| Mémoire | GDDR7 | HBM3 |
| VRAM | 96 Go | 80 Go |
| Perf. FP8 | 120 TFLOPS | 67 TFLOPS |
| NVLink | ❌ non | ✔️ oui |
| ECC | ✔️ oui | ✔️ oui |
Dans la majorité des usages professionnels :
- nombre limité de requêtes simultanées
- besoin d’un GPU fiable 24/7
- budget maîtrisé
→ La RTX Pro 6000 Blackwell offre le meilleur compromis : fiabilité ECC, puissance élevée et coût au Go imbattable.
Documentation officielle :
https://resources.nvidia.com/en-us-rtx-pro-6000
Benchmarks NVIDIA RTX Pro 6000 Blackwell (bientôt disponibles)
Nous publierons prochainement des benchmarks réalisés en interne sur :
- Llama 3.1
- Claude 3.5
- Stable Diffusion 3
- Workloads scientifiques
L’Accès Direct à la
puissance de Calcul IA.
Simulez votre configuration, estimez votre budget et démarrez un échange avec notre équipe technique. Nous vous aiderons à trouver le meilleur ratio performance / prix pour vos usages.